Коротко
- Мониторинг после запуска начинается с описания ожидаемого поведения, а не с поиска красивой итоговой метрики.
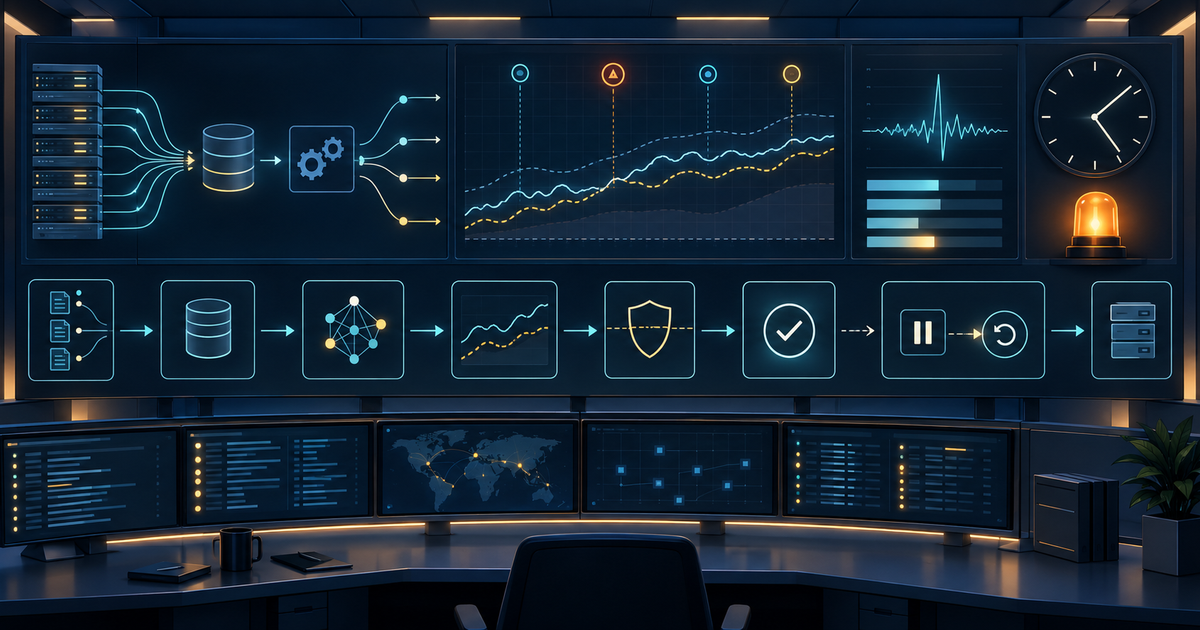
- Наблюдать полезно всю цепочку: данные, сигнал, заявку, исполнение, задержку, лимиты и состояние системы.
- Отклонение должно иметь timestamp, контекст и понятный следующий шаг: исследование, ограничение или пауза.
- Мониторинг повышает видимость процесса, но не исключает рыночный, операционный или технологический риск.
Сначала описать ожидаемое поведение
Проверяемый мониторинг сравнивает две записи: что система должна была сделать по версии правила и что фактически произошло. Формулировка «алгоритм работает» слишком широкая. Лучше заранее описать наблюдаемые ожидания:
| Слой | Ожидаемое поведение | Факт для сверки |
|---|---|---|
| Данные | источник, частота и timestamp доступны | пропуски, задержки, неожиданные значения |
| Сигнал | условие сработало по зафиксированной версии | событие, причина и время |
| Заявка | лимиты и параметры применены | отправленная, отклонённая или отменённая заявка |
| Исполнение | ответ сопоставлен с заявкой | цена, объём, частичное исполнение и задержка |
| Состояние | режим и версия известны | heartbeat, ошибки, паузы и обновления |
Такой baseline позволяет отличить ошибку в данных от ошибки в логике и от обычного расхождения между расчётной и фактической ценой. Для последнего полезен отдельный разбор проскальзывания и издержек.
Какие сигналы собирать
Данные и время
В журнале должны оставаться источник, timestamp получения, timestamp обработки и версия набора данных, если такая версия существует. Незаполненное поле нельзя автоматически считать нулём: пропуск должен быть заметен как состояние.
Сверка часов также относится к механике. Без единой временной шкалы трудно установить, какой сигнал был доступен до заявки, а какой появился после неё. Для исторической проверки это особенно важно, но и в live-контуре время определяет порядок событий.
Сигналы и заявки
Каждое решение связывается с причиной, версией алгоритма и параметрами, которые были доступны в момент события. Отдельно записываются попытки отправки, подтверждения, отклонения, отмены и повторные действия.
Такой журнал помогает ответить на простой вопрос: система не создала сигнал, сигнал не дошёл до исполнительного слоя или заявка не была исполнена. Не следует объединять все три ситуации в один статус «не сработало».
Исполнение и расходы
Сопоставление заявки и исполнения включает время, цену, объём, частичное исполнение, комиссию и доступную оценку slippage. В статье оценке автоматизированной стратегии до запуска эти слои разделены ещё до включения системы; после запуска их можно использовать как структуру наблюдения.
Сверка ожидаемого и фактического
Удобно начать с трёх классов отклонений:
- Техническое — нет данных, heartbeat, соединения, ответа сервера или нужной версии конфигурации.
- Исполнительное — заявка отклонена, исполнена частично, получила другую цену или задержалась.
- Поведенческое — последовательность действий отличается от правила при доступных и корректных данных.
В каждом случае фиксируются ожидаемое состояние, факт, время обнаружения, затронутая версия и решение оператора. Один и тот же код ошибки может иметь разную причину, поэтому полезен исходный event trail, а не только итоговый счётчик.
ESMA в материалах об algorithmic trading выделяет тестирование, лимиты, устойчивость систем и proper monitoring для соответствующих инвестиционных фирм. Эти материалы задают полезную контрольную рамку, но не являются утверждением о статусе ARM или заменой конкретной инструкции провайдера (Article 17 Algorithmic trading, supervisory briefing).
Реакция на отклонение
До запуска должна существовать лестница реакции:
- наблюдение — отклонение записано и не требует немедленной паузы;
- расследование — новые действия ограничены до проверки причины;
- пауза — система перестаёт создавать новые заявки по заранее определённому условию;
- упорядоченное закрытие или передача — отдельная процедура, если её предусматривают правила и инфраструктура.
Названия режимов и конкретные лимиты зависят от системы. Важно, чтобы переход был технически видим, имел владельца, timestamp и обратную проверку. «Остановить» без доказательства остановки — это незавершённое событие.
Ограничения мониторинга
Мониторинг показывает наблюдаемые события, но может пропустить неизвестный отказ, неверный источник данных или проблему вне доступного журнала. Наличие alert не доказывает, что реакция произошла вовремя. Итоговые показатели также не раскрывают причин без event trail.
Нельзя обещать, что мониторинг предотвращает убыток. Он помогает обнаруживать расхождения и принимать ограниченные операционные решения, тогда как рынок, ликвидность, инфраструктура и человеческий фактор остаются источниками неопределённости.
Практический чек-лист
- Описан baseline ожидаемого поведения для данных, сигналов, заявок и исполнения?
- У каждого события есть timestamp, версия и связь с предыдущим шагом?
- Разделены техническое, исполнительное и поведенческое отклонения?
- Видны отказы, частичное исполнение, задержки и расходы?
- Есть ли проверяемая процедура расследования, паузы и возврата?
- Можно ли восстановить цепочку событий после инцидента без догадок?
- Зафиксированы ограничения мониторинга и границы его применимости?
Такой список проверяет наблюдаемость процесса после запуска, но не превращает её в обещание результата.
Для связанного чтения доступны разделы технологии и риск, а техническую сторону расхождения расчётной и фактической цены разбирает статья о проскальзывании и издержках.